
로컬 LLM 시대, 내 컴퓨터가 AI가 된다
AI 활용 테크창 연구팀이 인공지능을 활용해 작성하고, 사실 확인과 편집 심사를 거쳐 발행한 칼럼입니다.
클라우드 API 요금 고지서를 보고 화들짝 놀란 경험이 있으신가요? 개발자 커뮤니티 사이에서는 조용하지만 강력한 흐름이 형성되고 있습니다. 바로 로컬 LLM(Local Large Language Model) — 인터넷 연결 없이 내 컴퓨터에서 직접 대규모 언어 모델을 실행하는 패러다임입니다. 코딩 보조, 문서 자동화, 개인 데이터 분석까지, 이제 AI는 클라우드 너머가 아닌 내 노트북 안에 있습니다.
왜 지금인가
로컬 LLM이 현실적인 선택지가 된 데는 세 가지 기술적 전환점이 있습니다. 첫째, 모델 경량화 기법의 비약적 발전입니다. 양자화(Quantization) 기술이 성숙하면서 수백 GB에 달하던 모델이 4~8GB 수준으로 압축되었고, 소비자용 GPU는 물론 고사양 CPU만으로도 실용적인 추론 속도를 낼 수 있게 되었습니다. 둘째, 오픈소스 모델 생태계의 폭발적 성장입니다. Meta의 Llama 시리즈, Mistral AI의 모델군, Google의 Gemma 등 상용 모델과 어깨를 나란히 하는 오픈웨이트 모델이 지속적으로 공개되고 있습니다. 셋째, 프라이버시와 비용이라는 현실적 압박입니다.
Stack Overflow의 「2025 Developer Survey」는 개발자들이 AI 도구를 빠르게 받아들이면서도 동시에 보안·프라이버시와 정확성에 대한 불안을 안고 있다는 '신뢰의 역설'을 보여줍니다. 구체적인 응답 비율은 바로 다음 '숫자로 보는 현황'에서 확인할 수 있습니다.
금융·의료·법률 도메인처럼 데이터 외부 전송이 규제되는 영역에서는 로컬 LLM이 선택이 아닌 필수가 되어가고 있습니다.
숫자로 보는 현황
로컬 LLM에 대한 관심은 체감이 아니라 발표된 조사로 확인됩니다.
- 개발자 신뢰도: Stack Overflow 「2025 Developer Survey」에 따르면, AI 에이전트의 보안·프라이버시를 우려하는 개발자는 81%, 정확성을 우려하는 개발자는 87%에 달했지만, AI 출력을 신뢰한다고 답한 비율은 29%에 그쳤습니다.
- 모델 생태계 성장: Hugging Face에 따르면, 2025년 한 해 동안 모델 허브에 새로 등록된 모델은 약 118만 개로, 이전의 모든 해를 합친 것보다 많았습니다.
- 국내 규제 대응: 금융보안원의 「금융분야 망분리 개선 로드맵」(2024년 8월)에 따르면, 금융회사가 외부 클라우드 LLM을 이용하려면 인터넷이 차단된 자사 클라우드 영역과 외부 모델 사이를 보안접속(private link)으로 연결해야 합니다.
세 수치는 같은 흐름을 가리킵니다. AI 도구는 빠르게 쓰이고 있지만 신뢰는 아직 못 미치고(Stack Overflow), 그 공백을 채울 오픈소스 모델은 폭발적으로 늘고 있으며(Hugging Face), 규제가 엄격한 산업에서는 외부 전송 자체를 구조적으로 제한하고 있습니다(금융보안원). 이 세 조건이 겹치는 지점에 로컬 LLM이 있습니다.
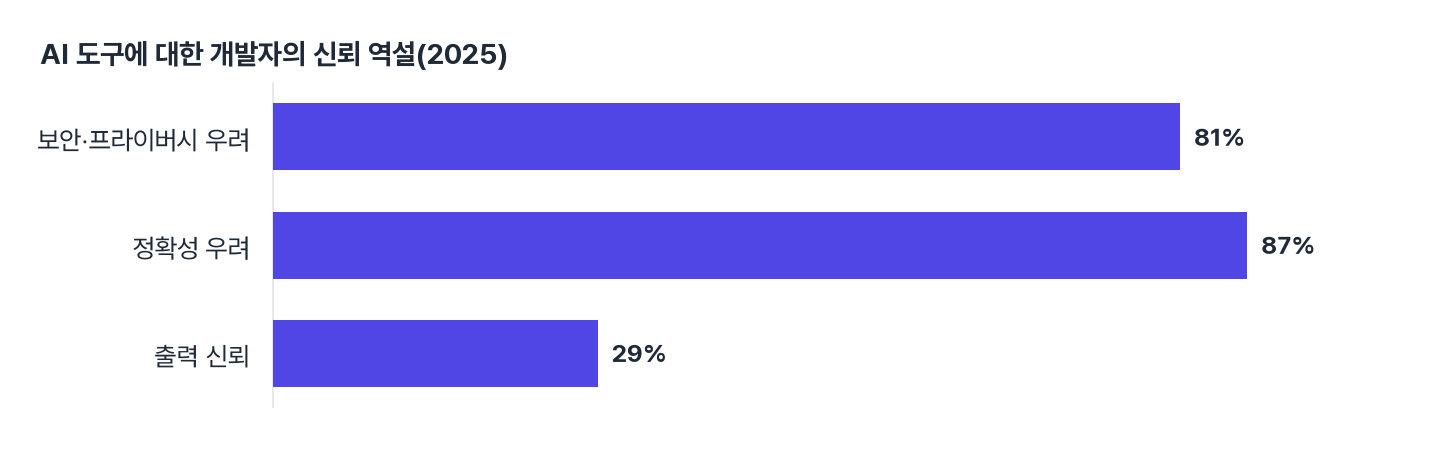
그림 1. AI 도구에 대한 개발자의 신뢰 역설(2025)
개발자 대부분이 AI 도구의 보안·정확성을 우려하면서도, 실제로 출력을 신뢰한다는 응답은 3명 중 1명에도 못 미칩니다.
단위: %. 출처: Stack Overflow, 「2025 Developer Survey」.
| 항목 | 응답 비율 |
|---|---|
| 보안·프라이버시 우려 | 81 |
| 정확성 우려 | 87 |
| 출력 신뢰 | 29 |
로컬 LLM 생태계의 실체
Ollama와 LM Studio: 진입 장벽을 무너뜨리다
과거 로컬 모델 실행은 Python 환경 설정부터 CUDA 드라이버까지 복잡한 준비 과정을 요구했습니다. Ollama는 이 과정을 ollama run llama3.2 한 줄로 압축했습니다. Docker처럼 모델을 이미지 단위로 관리하며, REST API를 기본 제공해 기존 애플리케이션과의 통합도 간단합니다. LM Studio는 GUI 기반으로 모델 다운로드부터 채팅 인터페이스, OpenAI 호환 로컬 서버 구동까지 지원해 비개발자도 쉽게 접근할 수 있습니다.
llama.cpp와 양자화: 작동 원리의 핵심
로컬 실행의 기술적 심장은 llama.cpp입니다. 순수 C/C++로 작성된 이 추론 엔진은 GPU가 없는 환경에서도 CPU만으로 LLM을 실행할 수 있게 하며, Apple Silicon의 Metal API, x86의 AVX 명령어셋 등 플랫폼별 최적화를 적극 활용합니다. 여기에 GGUF 포맷과 4비트 양자화를 결합하면, 13B 파라미터 모델을 8GB RAM 환경에서도 무리 없이 구동할 수 있습니다. 정보의 손실을 최소화하면서 모델 크기를 줄이는 이 기법은 에지 환경 배포의 가능성을 크게 확장시켰습니다.
코딩 특화 모델과 IDE 통합
개발자에게 특히 주목할 흐름은 코딩 특화 로컬 모델의 등장입니다. DeepSeek Coder, Qwen2.5-Coder 등은 코드 자동완성·리팩터링·디버깅에 특화되어 있으며, VS Code 확장인 Continue나 Cline을 통해 Ollama 로컬 서버와 연결하면 GitHub Copilot과 유사한 경험을 완전히 오프라인으로 구현할 수 있습니다.
한계: 로컬이 곧 더 똑똑하다는 뜻은 아니다
다만 로컬에서 돌린다는 것이 성능을 보장하지는 않습니다. 8GB급 양자화 모델은 최신 클라우드 플래그십 모델에 비해 추론 품질·맥락 길이에서 여전히 뒤처지는 경우가 많고, 양자화 수준이 높아질수록(예: 4비트 이하) 응답의 정밀도가 떨어질 위험도 커집니다. 로컬 LLM의 가치는 '더 똑똑함'이 아니라 '통제권과 비용·프라이버시'에 있다는 점을 분명히 해야, 과도한 기대로 인한 실망을 피할 수 있습니다.
현장의 변화
Mozilla는 llamafile이라는 오픈소스 프로젝트를 통해, 복잡한 설치 과정 없이 LLM 전체를 단일 실행 파일로 압축해 Windows·macOS·Linux 등 6개 운영체제에서 바로 실행할 수 있게 지원하고 있습니다. 로컬 AI를 '특별한 하드웨어 없이도' 누구나 쓸 수 있게 만들겠다는 취지입니다.
국내에서는 금융보안원이 2024년 8월 발표한 「금융분야 망분리 개선 로드맵」에 따라, 외부 클라우드 AI 서비스를 쓰더라도 인터넷이 차단된 금융회사 클라우드 영역과 외부 LLM 사이를 보안접속으로만 연결하도록 규정하면서, 여러 금융 IT 부서에서 온프레미스·로컬 LLM 기반의 내부 챗봇·문서 분류 시스템 도입을 검토하고 있습니다.
Hugging Face는 모델 허브에 GGUF 포맷 모델을 적극적으로 수용하며 로컬 실행 생태계를 공식 지원 영역으로 편입했습니다. 2025년 한 해에만 118만 개의 모델이 새로 등록된 성장세 속에서, GGUF로 양자화된 버전을 함께 제공하는 모델도 빠르게 늘고 있습니다.
시사점: 우리가 갖춰야 할 것
- Ollama 설치부터 시작하세요.
ollama run gemma3:4b명령어 하나로 첫 로컬 LLM 경험을 시작할 수 있습니다. 직접 실행해보는 것이 모든 이해의 출발점입니다. - 양자화 개념을 이해하세요. Q4_K_M, Q8_0 같은 표기가 무엇을 의미하는지 파악하면, 자신의 하드웨어에 적합한 모델을 스스로 선택할 수 있습니다.
- OpenAI 호환 API 구조에 익숙해지세요. 로컬 LLM 대부분이 OpenAI API 형식을 따르므로, 이 인터페이스를 배워두면 클라우드와 로컬을 코드 변경 없이 전환할 수 있는 유연성을 갖출 수 있습니다.
- Continue 또는 Cline 같은 IDE 플러그인을 로컬 서버와 연결해 보세요. 실제 개발 워크플로에 통합했을 때의 생산성 변화를 직접 체감하는 것이 중요합니다.
- 프라이버시와 라이선스를 함께 고려하세요. 로컬이라고 해서 모든 문제가 해결되는 것은 아닙니다. 오픈웨이트 모델의 상업적 이용 조건과 라이선스 차이를 반드시 확인하는 습관을 들이세요.
맺음말
로컬 LLM은 단순히 비용을 절감하는 수단이 아닙니다. 이는 AI 도구에 대한 통제권을 개발자 자신이 되찾는 움직임이며, 클라우드 의존도를 줄이고 데이터 주권을 지키려는 기술적 선언에 가깝습니다. 처음 배우는 단계라도 지금 당장 노트북에 Ollama를 설치해 모델 한 줄을 실행해 보세요. 그 순간, AI가 더 이상 어딘가 멀리 있는 서비스가 아니라 내 도구 상자 안에 있다는 감각을 얻게 될 것입니다.
참고 자료
- Stack Overflow, 「2025 Developer Survey」
- Hugging Face, 모델 허브 통계 및 관련 블로그 (huggingface.co)
- Ollama 공식 문서 (ollama.com)
- llama.cpp GitHub 저장소 — Georgi Gerganov et al.
- Mozilla Builders, 「llamafile」 프로젝트 공식 문서
- 금융보안원, 「금융분야 망분리 개선 로드맵」(2024)
테크창 연구팀 | 인천대학교 창의인재개발학과 전공심화연구모임
오늘 글에서 하나 가져간다면?
다 읽고 남은 한 가지를 한 줄로 적어 주세요. 다른 독자에게도, 다음 글을 쓰는 연구팀에게도 가장 좋은 신호가 됩니다.
댓글 (0)
아직 댓글이 없습니다. 첫 번째 댓글을 작성해보세요!