AI 코드가 그럴듯해 보이는 이유, 뇌과학으로 읽기
이 칼럼은 지난 편 'AI가 짜준 코드, 결국 사람이 검증한다'의 심화편입니다. 지난 편이 "왜 검증해야 하는가"를 다뤘다면, 이번 편은 한 걸음 더 들어가 "왜 우리는 틀린 코드를 맞다고 믿어버리는가"를 인지심리학과 통계적 언어모델의 작동 원리로 뜯어봅니다.
빈 배열을 넣으면 멈추는 정렬 함수, 존재하지 않는 함수를 불러오는 임포트문, SQL 인젝션에 무방비인 쿼리문. 이런 코드들의 공통점은 하나입니다. 처음 봤을 때 전혀 이상해 보이지 않는다는 것입니다. 검증이 필요하다는 사실은 이미 알고 있는데, 왜 우리는 그 검증을 자꾸 건너뛰게 될까요.
왜 지금인가
AI 코딩 도구는 이제 선택이 아니라 기본값입니다. 많은 개발자가 매일 AI 자동완성을 켜놓고 코드를 짭니다. 문제는 도구가 빨라진 속도만큼 검증 습관이 따라오지 못했다는 데 있습니다. 언어모델은 다음에 올 확률이 가장 높은 토큰을 예측하도록 학습되었을 뿐, 그 코드가 실제로 동작하는지 검증하도록 설계되지 않았습니다.
New York University 및 University of Calgary 연구팀의 'Asleep at the Keyboard' 연구는 Copilot이 생성한 코드 중 보안 취약점을 포함한 비율이 약 40%에 달한다고 보고했습니다.
유창함과 정확함은 서로 다른 축입니다. 이 사실을 모르고 자동완성을 쓰면, 매끄러운 문장에 속아 틀린 논리를 그대로 통과시키게 됩니다. 지금 필요한 것은 AI를 못 믿는 태도가 아니라, 어디를 의심해야 하는지 아는 감각입니다.
숫자로 보는 현황
- New York University·University of Calgary 'Asleep at the Keyboard' 연구: Copilot 생성 코드의 보안 취약점 포함 비율 약 40%
- Purdue University(Kabir et al., CHI 2024) 연구: ChatGPT 코드 답변 오답률 약 52%, 그중 사용자가 오답임을 알아채지 못하고 '그럴듯하다'고 판단한 비율 약 39%
- METR 2025 연구(2025년 7월 발표): 숙련 개발자가 AI 도구 사용 시 체감상 더 빨라졌다고 응답했으나, 실제 작업 완료 시간은 오히려 약 19% 더 걸림
- Stack Overflow 2024 Developer Survey: AI 도구에 호의적·매우 호의적이라는 응답이 72%였던 반면, AI 답변의 정확성을 '신뢰한다'는 응답은 약 43%, '매우 신뢰한다'는 응답은 3% 수준에 그침
이 수치들을 나란히 놓으면 하나의 패턴이 보입니다. AI가 만든 코드는 틀릴 확률이 낮지 않은데, 사람이 그것을 맞다고 느끼는 확률은 그보다 훨씬 높다는 것입니다. Stack Overflow 조사에서 호의적 응답(72%)과 실제 신뢰 응답(43%) 사이의 간극도 같은 패턴을 보여줍니다. 도구를 좋아하는 것과 그 결과를 검증 없이 믿는 것은 별개인데, 실무에서는 이 둘이 자주 뒤섞입니다.
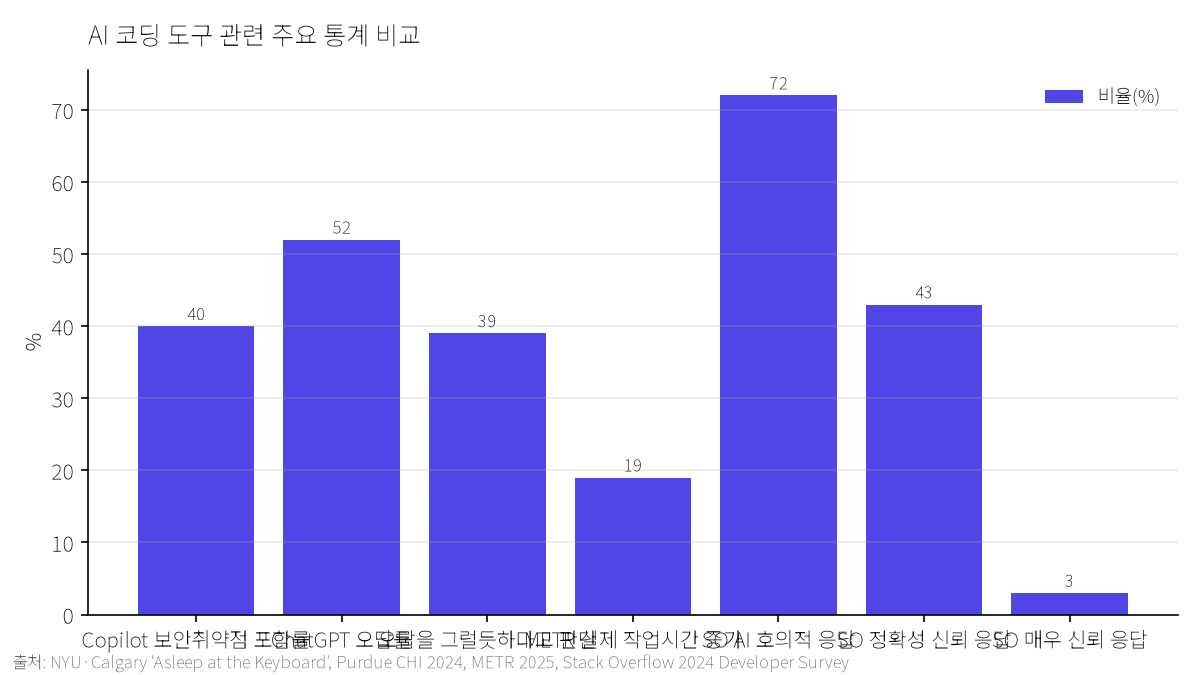
AI 코딩 도구 관련 주요 통계 비교 (단위: %)
| 항목 | 비율(%) |
|---|---|
| Copilot 보안취약점 포함률 | 40 |
| ChatGPT 오답률 | 52 |
| 오답을 그럴듯하다고 판단 | 39 |
| METR 실제 작업시간 증가 | 19 |
| SO AI 호의적 응답 | 72 |
| SO 정확성 신뢰 응답 | 43 |
| SO 매우 신뢰 응답 | 3 |
출처: NYU·Calgary 'Asleep at the Keyboard', Purdue CHI 2024, METR 2025, Stack Overflow 2024 Developer Survey
AI가 만든 코드의 실제 오류·취약점 비율은 사람이 느끼는 신뢰·호감 비율과 큰 간극을 보입니다.
그럴듯함의 정체
통계적 유창함 vs 논리적 정확성
언어모델은 방대한 코드를 학습하며 "이런 맥락 다음엔 이런 토큰이 온다"는 확률 분포를 익힙니다. 함수 이름, 괄호 짝, 들여쓰기, 변수명 관습까지 모두 이 확률 게임의 산물입니다. 그 결과 문법적으로 흠잡을 데 없고 스타일도 깔끔한 코드가 나옵니다. 하지만 확률이 높다는 것은 "이런 코드가 자주 등장했다"는 뜻이지 "이 코드가 지금 이 문제를 정확히 푼다"는 뜻이 아닙니다. 정확성은 실행과 검증을 거쳐야 확인되는데, 모델은 그 단계를 거치지 않고 텍스트만 생성합니다.
사람이 속는 이유: 유창성 휴리스틱과 자동화 편향
사람의 뇌는 처리하기 쉬운 정보를 더 신뢰하는 경향이 있습니다. 이를 유창성 휴리스틱이라 부릅니다. 문법이 매끄럽고 변수명이 관습적이며 주석까지 친절하면, 뇌는 "이건 검증된 지식"이라는 신호로 착각합니다. 여기에 자동화 편향이 더해지면 상황은 더 나빠집니다. 기계가 만든 결과물을 사람의 판단보다 우선시하는 경향인데, 특히 시간에 쫓기는 주니어 개발자일수록 이 편향에 취약합니다. Purdue 연구에서 오답을 그럴듯하다고 판단한 비율이 39%에 달했던 것도, 코드의 표면적 매끄러움이 판단력을 마비시켰기 때문입니다.
반론: 그래도 유창함이 무의미하지는 않다
다만 유창함이 전부 나쁜 신호는 아닙니다. 실제로 문법적으로 정돈된 코드는 컨벤션을 잘 지킨 코드일 가능성이 높고, 이는 협업과 유지보수에 실질적으로 도움이 됩니다. 문제는 유창함을 정확성의 '충분조건'으로 착각하는 순간입니다. 유창함은 가독성의 신호일 뿐, 동작 보증의 신호가 아니라는 구분을 유지하는 것이 핵심입니다.
현장의 변화
Spracklen 등의 package hallucination 연구는 여러 대규모 언어모델이 실제로 존재하지 않는 패키지명을 반복적으로 생성한다는 점을 확인했습니다. 이 이름은 관습적인 네이밍 규칙을 따르기 때문에 설치 전까지는 의심하기 어렵고, 공격자가 이 이름을 선점해 악성 패키지를 등록하는 공급망 공격 시나리오까지 제기되었습니다. 코드가 실행 전 단계에서부터 이미 위험을 내포할 수 있다는 뜻입니다.
빈 배열이나 중복값을 넣었을 때 실패하는 정렬·검색 코드는 학부 강의실에서도 흔히 재현됩니다. AI가 생성한 이진 탐색 코드에 빈 배열을 넣으면 인덱스 오류가 나거나, 중복값이 섞인 배열에서 예상과 다른 결과가 나오는 식입니다. 코드 자체는 교과서적으로 보이기 때문에, 직접 테스트 케이스를 돌려보기 전까지는 문제를 알아채기 어렵습니다.
SQL 인젝션 시나리오도 반복적으로 보고되는 패턴입니다. AI에게 "사용자 이름으로 조회하는 쿼리를 짜줘"라고 요청하면 문자열을 그대로 이어붙이는 코드가 나오는 경우가 많고, 이는 실무에서 실제 사고로 이어질 수 있는 전형적인 취약점입니다. 파라미터 바인딩을 명시적으로 요구하지 않으면 이런 결과가 나온다는 점은 여러 보안 가이드에서 공통적으로 지적하는 부분입니다.
시사점: 우리가 갖춰야 할 것
- 유창함과 정확함을 별개 신호로 분리한다. 코드가 깔끔해 보인다는 인상과 실제로 동작한다는 사실은 다른 층위임을 의식적으로 되뇌고, 판단을 내리기 전에 이 둘을 분리해서 평가하는 연습을 합니다.
- 실행 없이 신뢰하지 않는다. AI가 생성한 함수는 반드시 실행해보고, 빈 값·경계값·중복값 같은 엣지케이스를 직접 넣어 테스트합니다. 눈으로 읽고 넘기는 습관을 실행하고 확인하는 습관으로 바꿔야 합니다.
- 패키지·API는 항상 원본 문서에서 재확인한다. 낯선 함수명이나 처음 보는 패키지가 등장하면 공식 문서나 패키지 저장소에서 실제 존재 여부와 시그니처를 확인한 뒤 설치·사용합니다.
- 의심할 지점과 믿을 지점을 구분한다. 보일러플레이트나 반복적인 패턴 코드는 AI를 신뢰해도 괜찮지만, 비즈니스 로직의 핵심 분기나 보안·데이터 무결성에 관련된 부분은 반드시 사람이 직접 검토합니다.
- 체감 속도가 아니라 실측 시간을 기록한다. METR 2025 연구처럼 체감과 실제 사이에 괴리가 있을 수 있으므로, 스스로 작업 전후 시간을 기록해보고 AI 도구가 실제로 도움이 되는 영역을 파악합니다.
맺음말
AI가 짠 코드가 그럴듯해 보이는 이유는 그것이 애초에 '그럴듯하게' 만들어지도록 학습되었기 때문입니다. 이 메커니즘을 이해하면, 검증은 귀찮은 의무가 아니라 유창함과 정확함을 구분하는 자연스러운 절차가 됩니다. 오늘 짠 코드 한 줄에 빈 배열 하나만 넣어보는 것부터, 그 습관은 시작될 수 있습니다.
참고 자료
- Pearce, Ahmad, Tan, Dolan-Gavitt, Karri, 「Asleep at the Keyboard? Assessing the Security of GitHub Copilot's Code Contributions」(New York University·University of Calgary)
- Kabir et al., 「Is Stack Overflow Obsolete? An Empirical Study of the Characteristics of ChatGPT Answers to Stack Overflow Questions」(CHI 2024, Purdue University)
- METR, 「Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity」(2025)
- Stack Overflow, 「2024 Developer Survey」
- Spracklen et al., package hallucination 관련 연구(대규모 언어모델의 존재하지 않는 패키지명 생성 현상)
테크창 연구팀 | 인천대학교 창의인재개발학과 전공심화연구모임
댓글 (0)
아직 댓글이 없습니다. 첫 번째 댓글을 작성해보세요!